シミュレーション・制御・実機
倒立振子をLQRと強化学習で比べる:学習コストとLQRの遅延の限界
- 倒立振子
- 強化学習
- 制御
- LQR
- REINFORCE
- MuJoCo
- Gymnasium
- Coarse-ID
- iLQR
- BOXES
- sim2real
- 遅延
- 線形化
- 方策勾配
- actor-critic
- 運動方程式
- 学習曲線
- 準陰的オイラー
- 外乱
- 台車
- 摩擦
- Riccati
- DeepMind
- Barto
- Todorov
目次
台車の上にヒンジで棒を立て、台車を左右に押して棒を倒さないように保つ問題を、倒立振子と呼ぶ。小さくて全部見通せるのに、不安定な釣り合いを能動的に保ち続ける難しさを、歩くロボットと同じ形で持つ。そのため半世紀以上にわたり、制御とAIの最小の実験場であり続けてきた。制御理論は運動方程式から押し返す力を計算し、強化学習は運動方程式を使わずに試行錯誤から押し方を覚える。実機の台車‑振子とシミュレータとでは、遅延のような系の要素が食い違う1。
本稿は、ブラウザの中で運動方程式に従って動く倒立振子を、自分の手と自動操縦で立たせる対話デモを例に取る。
同じ倒立振子を制御理論と強化学習に解かせて同じ指標で測ると、それぞれは棒を立てるまでに何を支払っているのか。制御に遅延を足すと、その結果はどこまで保たれるのか。
賢く見える方法も無料ではなく、必ずどこかで払う。 MuJoCo の同じ環境で、1000ステップのうち倒さずに立っていられたステップ数を測った。現代制御の LQR は学習データなしで20シードすべてが1000、強化学習の REINFORCE は600エピソード・約43,000ステップ学習しても535だった。LQR はモデルで払い、強化学習はサンプルと不安定さで払う。制御に遅延を足すと、LQR の成功率100%は40msまで保たれ、80msで0%になる。
自分の手と自動操縦で倒立振子を立たせる
下の振子は、あなたのブラウザの中で本物の運動方程式に従って動いている。三つ、試してほしい。
- まず、あなたが操作する。 台車を直接ドラッグする(マウス、スマホなら指)か、◀ ▶ ボタン(← → キー)で押す。たぶん、すぐ倒れる。人間は不安定な釣り合いを保つのが苦手である。条件も対等ではない。◀ ▶ ボタンで押せる力は12N、ドラッグのときはポインタへ引っぱるバネが働く(自動操縦と同じ60Nまで)。それでも、倒れる原因は力の上限だけではない。このデモの物理を手元で再実装して確かめると、12Nを押すか押さないかだけの入力でも、台車の位置と速度、棒の傾きと角速度の4つを毎瞬見て押し返せば、初期値を変えた20通りすべてが5000ステップ立ち続けた。傾きと角速度の2つだけでは、同じ20通りとも台車が軌道の端へ流れて終わった。力の大きさより、何を見て、どれだけ速く押し返すかの差が大きい。
- 次に、自動操縦に任せる。 「フィードバック則」は、傾きと速度から押す力を毎瞬計算する(線形二次レギュレータ、LQR)。退屈なほど簡単に立て続ける。
- 最後に、遅延を足す。 スライダーを60ミリ秒(3ステップ)へ動かすと、棒は倒れない。けれど止まらなくなる。±14°ほどの振れが、いつまでも収まらない。そこからもう一段、80ミリ秒(4ステップ)にすると、自動操縦は倒れる。 これがsim2realギャップだ。実機の作動には遅延があるが、シミュは既定ではそれを入れていない。
「あなたが操作」モード。台車を直接ドラッグ(マウス/指)するか、← → かボタンで押し、棒を立て続けてください。
デモで確かめられるのは二つである。自動操縦(LQR)はデータ0で完璧に立てること。そして、その完璧さは遅延が小さい(このデモでは40msまで)という前提に乗っていること。
同じ問題を、二つの流派で解かせて測る
棒が立つかどうかで優劣は付かない。付くのは、立てるまでに何を先に渡したかの差である。LQR には物理モデルを渡し、強化学習には試行錯誤の時間を渡す。比べる指標は一つだけ置く。それは、1000ステップのあいだに、倒さず何ステップ立っていられたかである。この指標で比べるのは LQR と強化学習の二つで、どちらも MuJoCo の同じ環境で測った。手で押せるブラウザ用の振子は別の実装で、力の上限も転倒閾値も1ステップの長さも違う。∴ ここで「人間 対 機械」の勝敗は付けられない。
シミュレータは MuJoCo(Multi-Joint dynamics with Contact)の InvertedPendulum。流派は、現代制御の LQR と、強化学習の REINFORCE。全部、手元のマシンでオフラインに走らせた、本物の数字である。GPUを使ったのはPyTorchの方策の学習だけで、LQR側はCPUで走っている。
流派A:LQRに「モデルを渡す」
LQRには、世界の物理を教える。中身は、倒立点のまわりで運動方程式を線形化することである。倒立点の近くだけ、複雑な物理を直線で近似する。ただし今回それを紙の上で解いてはいない。シミュレータを任意の状態にセットする権限(set_state)を使い、有限差分で突いて線形モデルを読み出した。実機では入手しにくい特権である。得た線形モデルから、「いまどれだけ傾いているか」から「どれだけ押し返すか」を、数学的に最適な形で計算させる。一行で書けば、次のようになる。
押す力 = −(傾きや速度のズレ)×(モデルから決まる重み)
「ズレに比例して押し返す」だけ。ただしその重みは、物理を知っているからこそ決まる。もっとも、何を「最適」とするかの基準は手で選んだ値である。状態の重みは Q=diag(1,10,1,1)、入力の重みは R=0.05 とした。MuJoCo側の並びは なので、この Q は棒の角度に10倍の重みを置いている。
結果:20シードすべてで1000ステップ中1000ステップ、成功率100%。使った学習データはゼロ。ゼロなのは学習サンプルであって、無コストという意味ではない。線形モデルを読み出すためのシミュレータ操作と、重みの手選びが先に要る。ブラウザ用の対話デモの自動操縦も同じ考え方だが、同じ実験ではない。ブラウザ側は古典的な台車‑振子で、力±60N、|θ|>0.9radで転倒する。この測定のほうはMuJoCoの InvertedPendulum-v4 で、行動は ctrl ±3、環境XMLの gear="100" が掛かるので台車に効く力は±300N、|θ|>0.2radで転倒する。Gymnasiumのドキュメントは行動の単位を “Force (N)” と書いているが、±3 は ctrl の範囲であって、ニュートンで測った力そのものではない。MuJoCo側は力が強い代わりに許される傾きが4分の1以下で、別物の難しさである。1ステップの長さも違う。ブラウザ側は0.02秒、MuJoCo側は frame_skip 2 × timestep 0.02 で0.04秒だ。以下の数字はすべてMuJoCo側のものである。
流派B:強化学習に「サンプルを渡す」
REINFORCEには、物理を一切教えない。手がかりは試行錯誤だけだ。デタラメに押すところから始め、たまたま棒が少し長く立った方向へ、自分を少しずつ寄せていく。マニュアルなしで、転びながら自転車を覚えるのに近い。
結果が下の図だ。600エピソード・約43,000ステップ練習しても、学習を止めてから測った評価は1000中535ステップだった。ただしこの535は、下の図の赤線の上には無い。赤線は探索ノイズを入れたまま学習中に測ったバッチ平均で、終端はおよそ97ステップ。535のほうは、学習後にノイズを切って決定論的に20本走らせた、別の測定である。しかも不安定で、学習曲線はエピソード350あたりで一度ピーク(平均207ステップ)に届いた後、崩れ、また少し戻る。高分散な方策勾配について言われる振る舞いと合うが、これは torch seed 0 の学習ラン1本の結果である(評価はどちらも20シード)。LQRのゲインは学習を伴わない決定的な値なのに対し、強化学習側は学習シードを振っての確認をしていない。非対称はここにある。学習を通して、一度も1000ステップを立ち切れなかった。
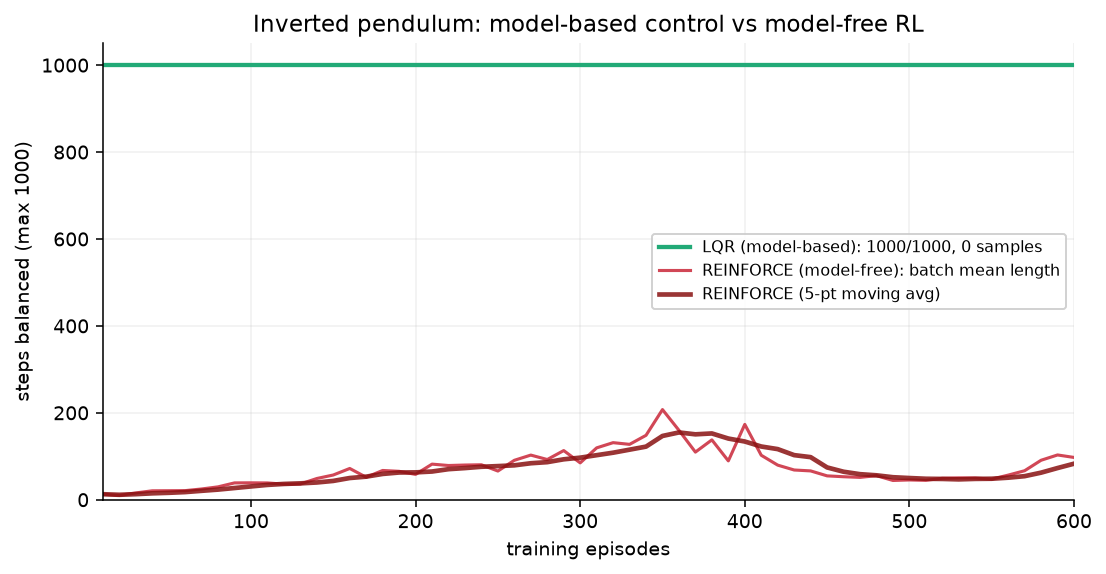
緑の直線がLQR(データ0で天井に張り付く)、細い赤がREINFORCEのバッチ平均、太い赤がその5点移動平均である。同じ問題、同じ指標で、これだけ違う。
同じ問題、違う「通貨」
どちらも棒は立てられる。けれど、支払う通貨が違う。
- LQR は「モデル」で払う。物理を知っている(測れている)必要がある2。その代わり、データ0で完璧。
- 強化学習 は「サンプルと不安定さ」で払う。モデルは要らない。その代わり、600回転んで約43,000ステップぶんの経験を使い、今回は半分しか立てなかった。
この対比は後付けではない。後で出てくる Barto・Sutton・Anderson 1983 は、このベンチマークを広めた論文である。その要旨自体が、「台車‑振子の運動方程式は既知でないと仮定する」と明示し、そこで手に入る評価信号は「標準的な適応制御が要求するよりずっと質が低い」と断っている3。モデルを取り上げると何が高くつくかは、問題設定のほうに最初から書き込まれていた。
(公平のための補足:今回のREINFORCEは最も素朴なRLである。PPOやSACといった現代的な手法は、今回走らせていない。だからこの535はRLの上限ではない1。ここで見たいのも上限ではなく、支払う通貨が違うという構造のほうだ。また今回並べたのは、モデルを読み出せる一つの環境の中だけである。モデルが書けない問題でどちらが有利になるかは、測っていない。)
本当の問いは、それは何を、どこで支払ったのかである。その「どこ」を測るのが、エンジニアリングの本体だ。理論上いくら賢くても、有限の予算の中で何を払わされるかは別問題だ。舞台を変えても同じ話である。
制御の遅延も、同じ構図に重なる。LQR はいま見えている傾きに対して押し返す。遅延はその「いま」を過去にする。押し返す力が現在の傾きと合わなくなれば、制御は振動を打ち消せずに増幅させる。ブラウザ用の台車‑振子では、60msで完璧ではなくなり(倒れないが振れが止まらない)、80msで崩れた。MuJoCo側でも同じことを測った(注6)。結果は、倒れたかどうかで見れば崖のように見える。40ms(1ステップ)では20シードすべてが1000ステップ完走して成功率100%のまま、80ms(2ステップ)では成功率0%・平均24ステップで倒れる。ブラウザ側とは別の台車‑振子で、力の上限も刻みも違うのに、80msで崩れるという一点は一致した。ただしこの台車は40msより細かい遅延を表現できない(1ステップ=40ms)ので、崖が40msと80msのどちらに寄っているかは、この計器では決められない。ブラウザ側の「60msで振れが止まらない」はその区間の中にある。生存ステップ数は倒れたかどうかしか数えないので、その60msのように倒れずに振れ続ける段階があっても、この指標には出ない。∴ LQR の100%は、遅延が小さいという前提の上に載った100%で、40msまでは保たれ、80msでは残らない。賢さの通貨も、シミュが既定では入れていない遅延も、同じ一言を指している。どこかで必ず払う。
ベンチマークとシミュレータの出自
面白いのは、この分野の二本の柱が、どちらも「運動」と「脳」を理解しようとした人たちから生まれていることだ。
- 倒立振子が学習制御のベンチマークとして広まったのは 1983年、Barto・Sutton・Anderson の論文からだ。“Neuronlike adaptive elements that can solve difficult learning control problems”(IEEE Trans. SMC-13: 834–846)は、後の actor-critic の原型を導入した。しかもその枠組みを動物の条件づけ・神経科学との関係で論じている。ブラウザ用の対話デモの棒は、質量も長さも刻み幅もこの論文の棒と同じものだ(下の「仕組み」を参照)。ただし始点はここではない。同じ問題を試行錯誤で解かせる試みは、Michie & Chambers の “BOXES: An experiment in adaptive control” が先行している(Machine Intelligence 2, 1968, pp.137–152)。副題のとおり狙いは最初から「適応制御の実験」で、書籍は E. Dale and D. Michie 編、Edinburgh の Oliver and Boyd 刊。
- そのMuJoCo自体、運動の制御を研究する神経科学者 Emo Todorov が作ったもの。しかも Todorov は、非線形な生体運動に線形二次レギュレータを反復適用する iLQR(Li & Todorov, 2004)の共著者でもある。この記事が対立させる二つの流派は、舞台を作った一人の中で地続きだった。DeepMindが2021年に買収し、2022年にApache 2.0でオープンソース化したからこそ、今日この実験を誰でも無料で走らせられる。
ベンチマークもシミュレータも、出発点は「動きと脳をどう理解するか」だった。
仕組みを数式で書くとどうなるか(クリックで展開)
台車の状態は4つの数 で表す(台車位置・台車速度・棒の角度・角速度。 は鉛直からの傾きで、0 が真上)。物理定数は台車 、棒 、棒の半長 、重力 、加える力 。ここに書く式は、ブラウザ用の対話デモが内部で計算しているものと同一だ。この4つ(, , , )と、次に出てくる 秒は、上で触れた Barto・Sutton・Anderson 1983 が使った値そのものである。ただし同論文は台車とヒンジの摩擦(、)を含み、力は N、積分は素のオイラーだった4。ここでは摩擦を落としている。これは後の Gym 系と同じ選択だ(Gymnasium の CartPole も摩擦なしの軌道として書かれている)。一方、力の N と準陰的オイラーはブラウザ側の選択で、Gym 系の CartPole は力 N、既定の積分は素のオイラーである。
- 運動方程式(標準の台車‑振子)。 力 と現在の状態から、台車の加速度 と棒の角加速度 を出す。分母の は、棒を一様な剛体棒とみなしたときの慣性モーメントから来る項である。
- 一歩進める(準陰的オイラー、 秒=50Hz)。 まず加速度で速度を更新し、その更新後の速度で位置を進める(速度を先に使うこの順序=準陰的オイラーは、素朴なオイラーより振動系で安定する)。
- 自動操縦=LQR(線形二次レギュレータ)。 4つの状態それぞれに重み を掛けて足し、その符号を反転した力を加える=。ゲイン は、上の非線形式を真上まわりで線形化したモデルに対して解いた固定値だ。ただし正直に書いておくと、解くときに使った重み は記録が残っておらず、格子探索でも復元できなかった(最良でも要素差 2.7 程度)。解いたあとに手で調整した可能性も排除できない。確かめたのは、この がこの非線形シミュを実際に安定化すること(5シード×5000ステップで一度も倒れない)までである。力は にクランプする。
-
遅延=この記事の主役の一つ。 制御が計算した力をすぐには効かせず、いったんキューに積んで ステップ遅らせてから台車に渡す(ブラウザ用の対話デモでは を 0〜6 ステップ=0〜120ms で動かせる)。完璧なはずの LQR でも、遅延が積もるとゲインの符号合わせが間に合わなくなり、振動が増幅して転倒閾値を超える。手元で同じ物理を再実装して確かめた結果はこうだ。0/20/40 ms では が指数的に 0 へ収束する(1,000ステップごとの最大 が桁で落ち続け、最後の窓では 未満)。60 ms になると平衡そのものが不安定になる。それでも振れ幅は一定の大きさで頭打ちになる。力は最大でも約58 Nで、上限の N には届かない。頭打ちを作るのは、傾きが大きくなるほど効く運動方程式の非線形な項である。20,000ステップ倒れないが収束もせず、 は 0.2416 rad(約 13.8°、転倒閾値の約 27%)の定常振動に落ち着く。試した500通りの初期値がすべて同じ振幅へ行き着いた。そこから一段上げた 80 ms では、振れ幅が育ち続けて 0.9 rad を超え、多くは100ステップ余り(約2秒)で倒れる。つまり境界は 40 ms と 60 ms のあいだにある。線形化した閉ループの成長率は 40 ms で 0.977、60 ms で 1.006 と、1 をまたぐ。棒が落ち着いたところで「つつく(外乱)」を当ててみると、0/20/40 ms は50回中0回、60 ms は50回中16回倒れた。ただしこの16回は、外乱の時刻と向きをランダムにした試験の1標本で、乱数列を変えれば回数は動く。0/20/40 ms の0回のようには固定しない。「倒れる/倒れない」の二値では 40 ms と 60 ms が同じに見えるが、外乱を一発入れれば違いは出る。以上の測定は、実機には在ってシミュが既定では入れていない遅延というsim2realギャップを手元で再現している。棒が 傾くか台車が軌道端()に達したら「転倒」。
-
強化学習側(流派B)。 MuJoCo の
InvertedPendulumを REINFORCE(最も素朴な方策勾配)で600エピソード学習させた。評価は学習を止めた固定方策で「1000ステップ中、何ステップ立てたか」を、探索ノイズを切って20本走らせた平均。LQR と違い学習データを要し、結果は高分散だった。学習の設定は次のとおり。環境はInvertedPendulum-v4(行動は ctrl ±3=実効 ±300 N、|θ|>0.2radで終了)、最適化は Adam・学習率 3e-3、割引なし(γ=1)、ベースラインは収益の指数移動平均、更新は10エピソードごとのバッチ、評価は決定論的な20本。 -
MuJoCo 側の遅延掃引(2026-09-01 実測)。 制御と台車の間に長さ の FIFO を挟み、制御は ステップ前の観測に対して力を決める。LQR の導出(有限差分による線形化 → Riccati 反復)・重み ・20シード・1000ステップ上限は本文の測定と同一で、 は記録済みの結果を再現する(ゲイン ・平均1000ステップ・成功率100%)。結果は 0ms/40ms で成功率100%(20/20 が完走)、80ms で成功率0%(平均24ステップ・最短19)、120〜200ms でも平均19〜20ステップ。⚠ 1ステップ=40ms なので、この台車は40msより細かい遅延を表現できない。崖が40〜80msのどこに在るかは、この計器では決められない。掃引スクリプトと結果 JSON は本文の測定と同じ来歴管理下に置いてある。⚠ 本文の LQR/RL の数値は RTX 3090 で取ったものだが、本掃引は CPU で走らせた(LQR は numpy のみで GPU を使わない)。同一性の根拠は機械ではなく、 がゲインと結果を完全に再現したことである。
出典4件
-
M. P. Deisenroth ほか「Gaussian Processes for Data-Efficient Learning in Robotics and Control」IEEE TPAMI, 2015. https://doi.org/10.1109/TPAMI.2013.218 — 遷移モデルを推定し、実機の台車‑振子の振り上げと静定を17.5秒の操作で学ぶ。シミュとの差に遅延を挙げる。 ↩ ↩2
-
S. Dean ほか「On the Sample Complexity of the Linear Quadratic Regulator」Found. Comput. Math., 2020. https://doi.org/10.1007/s10208-019-09426-y — 力学が未知の LQR を、少数の試行で推定したモデルと誤差から設計する(Coarse-ID)。モデルは試行で買える量でもある。 ↩
-
A. G. Barto ほか「Neuronlike Adaptive Elements That Can Solve Difficult Learning Control Problems」IEEE Trans. SMC, 1983. https://doi.org/10.1109/TSMC.1983.6313077 — 運動方程式を未知とする制約は、Michie & Chambers に倣い意図して課した。 ↩
-
Barto ほか 1983 の付録の定数表. https://doi.org/10.1109/TSMC.1983.6313077 — 台車1.0kg・棒0.1kg・棒の半長0.5m・重力9.8・摩擦2種・力±10N。掲載した結果は刻み0.02秒のオイラー法で出した。 ↩
この記事はAIを使用して執筆されました。内容には誤りが含まれる可能性があります。事実や数字の出典は脚注から確かめられます。